Этой весной Apple официально объявила: Mac Pro умер.
Когда Apple использовала процессоры Intel и видеокарты AMD, концепция башенного компьютера с возможностью расширения и апгрейда имела смысл. Но чипы Apple Silicon объединяют ЦП, ГП и интерфейс памяти в одном корпусе так, что подобная апгрейдопригодность становится не только излишней, но и невозможной. По крайней мере — без утраты некоторых ключевых преимуществ этих чипов.
И как ни странно, сочетание у Apple Silicon быстрой ЦП, приличного ГП и архитектуры объединенной памяти сделало его хорошим решением для современной «профессиональной» рабочей нагрузки, которая действительно нагружает топовое железо: запуск языковых моделей и агентов локально.
Это и есть основная аудитория для M5 Ultra Mac Studio, самой навороченной конфигурации Apple, которая перескочила через два поколения процессоров за одно обновление (напомню, M4 Ultra не было). Самые дорогие версии Studio всегда казались излишними для большинства людей, но теперь появился особый тип разработчика или дизайнера, одержимого ИИ, который действительно может получить ощутимую выгоду от наличия такой системы на рабочем столе.
Apple была застигнута врасплох спросом на эти системы со стороны людей, запускающих такие программы, как OpenClaw, и работающих с открытыми моделями локально; вместе с вызванным ИИ дефицитом памяти это и объясняет, почему в последние месяцы большинство этих систем практически невозможно было купить. Именно в этот контекст выходит новая Mac Studio.
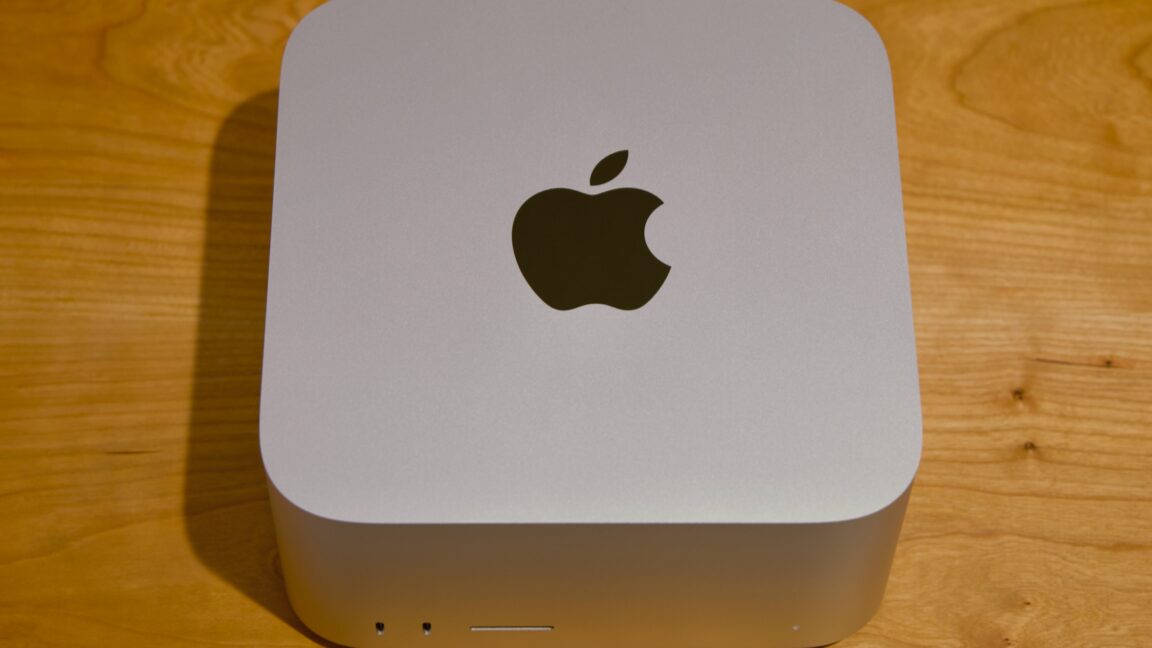
Новый Mac Studio выглядит так же, как и при запуске с M1 Max и M1 Ultra в 2022 году. Это маленькая, приземистая коробка с тем же следом 7,7 на 7,7 дюйма, что и у старого Mac mini, но выше. Варианты Max и Ultra внешне одинаковы, однако версия с M5 Ultra тяжелее на два фунта из‑за более массивного, но более проводящего меди радиатора, помогающего охлаждать более мощный чип.
Обе модели Studio также почти одинаковы по набору портов. Сзади расположены четыре порта Thunderbolt 5 со скоростью 120 Гбит/с, порт Ethernet 10 Гбит/с, HDMI 2.1 и пара USB‑A 5 Гбит/с. Спереди у обеих Studio есть картридер UHS‑II для SD‑карт, но у версии Max есть два порта USB‑C 10 Гбит/с, а у Ultra — еще два порта Thunderbolt 5 по 120 Гбит/с.
Дополнительная мощь Ultra распространяется и на поддержку внешних дисплеев. M5 Max поддерживает до пяти внешних дисплеев, а M5 Ultra — до восьми, хотя при этом есть оговорки в зависимости от разрешения и частоты обновления.
M5 Max уже известен и с марта поставляется в MacBook Pro. Он улучшился по сравнению с прошлым поколением M4 Max, введя новые «супер» ядра для ЦП и увеличив максимальную пропускную способность памяти с 546 ГБ/с до 614 ГБ/с. Число графических ядер осталось прежним (40), но новые нейронные акселераторы, встроенные в каждое GPU‑ядро, повысили его производительность для ML/AI‑функций, таких как масштабирование MetalFX и генерация кадров.
M5 Ultra — более крупный отрыв по нескольким причинам. Во‑первых, не было M4 Ultra, так что фактически мы перескочили два поколения процессоров при одном поколении продукта.
Во‑вторых, способ конструирования чипа изменился значительно. M1 Ultra, M2 Ultra и M3 Ultra по сути представляли собой пару Max‑чипов, соединенных высокоскоростным интерфейсом, чтобы получить преимущества большого монолитного чипа без производственных сложностей создания одного огромного кристалла.
M5 Ultra по сути все еще состоит из пары M5 Max, скрепленных вместе; в этом плане ничего не изменилось. Чип включает до 12 «супер» ядер ЦП, до 24 энергоэффективных ядер, до 80 GPU‑ядер, 32 ядра Neural Engine, два движка декодирования видео и четыре движка кодирования, а также чуть более 1,2 ТБ/с (да, это ТБ с большой буквы) пропускной способности памяти. Это аккуратное удвоение всех основных характеристик M5 Max.
Что изменилось, так это то, что в этом поколении M5 Pro и M5 Max уже сделаны из пары чиплетов, соединенных кремниевым интерфейсом, что означает, что M5 Ultra фактически состоит из четырех отдельных кусков кремния в одном корпусе. Потенциальный минус такой компоновки в том, что межкристальные соединения зачастую не могут передавать данные так же быстро, как компоненты на одном кристалле. В целом, Fusion‑архитектура не мешала предыдущим Ultra‑чипам быть быстрыми, и она не мешает M5 Ultra быть быстрым тоже. Но производительность Ultra‑чипов никогда не масштабировалась идеально линейно с ростом числа ядер, и M5 Ultra демонстрирует тот же эффект.
Обычно можно было бы просто описать аппаратный прогресс в новом Mac, предполагая равные условия по цене — то есть что новое железо автоматически выгоднее старого, если продается по той же цене. Но в этом году Apple повысила цены повсеместно из-за продолжающегося, вызванного ИИ, дефицита памяти. Как самый топовый компьютер компании с самыми дорогими конфигурациями памяти и хранения, Mac Studio пострадал сильнее других Mac.
При анонсе базовый M4 Max Mac Studio стоил 1 999 долларов; за эти деньги вы получали немного урезанную версию чипа, 36 ГБ оперативной памяти и 512 ГБ накопитель. M5 Max Studio стартует с 2 499 долларов — прибавка в 500 долларов. M3 Ultra Mac Studio с урезанным чипом, 96 ГБ оперативной памяти и 1 ТБ хранения стоил 3 999 долларов; та же конфигурация M5 Ultra обойдется в ошеломляющие 5 499 долларов — рост на 1 500 долларов. И это базовые модели. Полностью включенная M5 Max с 64 ГБ ОЗУ и 1 ТБ накопителем — то, что я бы назвал оптимальным соотношением цена/производительность для экспериментов с локальным ИИ — будет стоить 3 799 долларов, на 900 больше, чем стоил бы M4 Max Studio при запуске.
А Ultra? Модель с 256 ГБ ОЗУ и 1 ТБ хранилища, которая 18 месяцев назад стоила бы 5 599 долларов, теперь стоит 9 499 долларов — не совсем вдвое, но близко, и это ощущается соответствующе. Будет версия M5 Ultra с 512 ГБ, но Apple не раскрыла ее стоимость. Версия M3 Ultra стартовала с 9 499 долларов, так что вполне вероятно, что версия M5 Ultra будет стоить от 20 000 долларов и выше. Чтобы заинтересоваться высокопроизводительным локальным ИИ, вы уже должны быть готовы заплатить больше за железо, чем за использование дата‑центра на базе Nvidia. При таких ценах покупка кластера Mac Studio ощущается как оплата за постройку собственного дата‑центра за свой счет.
Имейте это в виду, когда мы перейдем к обсуждению производительности.
M5 Ultra, по почти всем показателям, — это самый быстрый процессор Apple Silicon на сегодняшний день. Единственное место, где он уступает, — однопоточная производительность ЦП, где скромный M6 в Mac mini побеждает его с небольшим отрывом. Но разрыв мал — меньше, чем между поколениями M3 и M4, например — что делает обновление менее драматичным, чем было при запуске прошлогодней Studio с M4 Max и M3 Ultra.
В многих наших общих тестах ЦП и ГП процессор Ultra опережает M5 Max на 80–90 процентов, а GPU быстрее на 50–80 процентов. Это в целом соответствует тому, что мы наблюдали у прошлых Ultra‑чипов — ЦП ближе к двукратному масштабированию, чем GPU. По сравнению с уходящим M3 Ultra, M5 Ultra обычно показывает примерно на 30 процентов более высокую однопоточную скорость ЦП, на 50 процентов быстрее многоядерную, а GPU‑производительность выше где‑то на 33–66 процентов в зависимости от теста. Как и следовало ожидать для прыжка через два поколения, разница заметная.
Но мы также заметили и менее ожидаемое поведение. Мультиядерный результат Ultra в Geekbench всего лишь примерно на 26 процентов выше, чем у Max, а в нашем тесте перекодирования видео Handbrake на CPU Max на самом деле быстрее завершил H.264‑кодирование (и едва уступил в H.265).
Анализ потребления энергии дает возможное объяснение. По данным инструмента powermetrics, и M5 Max, и M5 Ultra потребляют в среднем около 75 Вт во время теста транскодирования видео. Это примерно столько же, сколько потреблял M3 Ultra Mac Studio. Исторически Max‑студии расходовали меньше энергии, чем Ultra. Для меня это означает, что M5 Ultra, вероятно, ограничивают по питанию, чтобы удержать его в рамках штатного энергопотребления и охлаждения существующего дизайна Studio.
Но это также может быть и багом. При просмотре Activity Monitor во время задачи кодирования видео вы не видите, чтобы все CPU‑ядра работали на 100 процентов, что обычно наблюдается в этом тесте. И powermetrics показывает, что все ядра Ultra работают на тех же устойчивых тактовых частотах, что и M5 Max, на протяжении всего теста. Если бы имело место троттлинг по питанию или температуре, частоты были бы ниже. Я сообщил о своих наблюдениях в Apple и сообщу, если получу ответ.
Последнюю неделю я в основном учился самостоятельно тому, что называется vibe coding, так что простите, если что‑то изложу неточно. Многие поставщики моделей, включая Apple, также выпустили модели, которые частично обходят некоторые из этих жестких фактов. Но в целом это должен быть корректный краткий курс по локальному ИИ.
Когда речь идет о запуске моделей ИИ локально, есть два аппаратных показателя, которые имеют наибольшее значение. Первое — объем памяти GPU. Второе — пропускная способность памяти, то есть насколько быстро GPU может обмениваться данными с остальной системой.
Ваш графический ОЗУ определяет и размер моделей, которые вы можете запустить — модели в основном должны быть загружены целиком в память GPU, потому что в противном случае данные либо переполнятся в системную память (медленнее), либо, в худшем случае, на диск (еще медленнее).
Кроме того, особенно в кодинге, вам нужна дополнительная память для «контекста», то есть объема информации, которую агент может хранить в памяти до исчерпания. Для простого чат‑взаимодействия много контекста не требуется. Для разработки полноценного приложения желательно иметь большое количество ОЗУ для контекста, чтобы агент не «забыл», что он делает, на полпути к выполнению сложной задачи.
Существуют механизмы передачи — один агент может сжать сессию в один файл с большей частью релевантной информации и передать его другому, фактически сбрасывая контекст. Но с такими механизмами неизбежно теряется часть информации, особенно если изначально в сессии не так уж много контекста.
Пропускная способность памяти — не единственный фактор, определяющий, насколько быстро модель будет генерировать новые слова («токены»), но, вероятно, это самый важный. Даже скорость и возможности GPU, к которому прикреплена память, намного меньше значат в сравнении с объемом памяти и тем, как быстро компьютер может двигать данные в нее и из нее.
Apple Silicon‑маки стали популярны для запуска таких моделей, потому что они попали в золотую середину. Они не дают такой же пропускной способности памяти, как выделенная настольная видеокарта (пятигодичный Nvidia GeForce RTX 3060 12GB предлагает 360 ГБ/с — почти на 20 процентов больше, чем M5 Pro; RTX 5070 12GB предлагает 672 ГБ/с — больше, чем M5 Max). Но 64‑гигабайтный Apple Silicon Mac предлагает больше графической памяти, чем любая одиночная потребительская GPU, его пропускная способность памяти достаточно высока, а он существенно энергоэффективнее, чем RTX 5090 или пара RTX 3090. А системы с 96 ГБ, 128 ГБ, 256 ГБ и 512 ГБ Apple Silicon открывают доступ к еще большим, передовым моделям.
Очевидно, эти топовые системы сейчас недешевы, но это объясняет, почему стало трудно купить даже Mac mini. И отчасти благодаря тому, что железо хорошо подходит для этих задач, фреймворк Apple MLX стал достаточно оптимизированным и поддерживаемым разными языковыми моделями и локально ориентированными приложениями, такими как LM Studio Bionic.
Кроме этих показателей существует еще «время до первого токена» (time to first token, TTFT) — время от передачи запроса модели до момента, когда она начинает выдавать ответ. Тут поколение M5 улучшилось относительно M4 и более старых: нейронные акселераторы, которые Apple добавила к GPU, существенно ускоряют TTFT, делая любую локальную модель более отзывчивой.
Добавьте к этому то, что M5 Ultra значительно увеличил пропускную способность памяти по сравнению с M3 Ultra, и вы поймете, почему именно этот Mac Studio хорошо подходит для такой работы. Факт двухпоколенного прыжка относительно прошлогоднего M3 Ultra делает его еще заметнее по сравнению с M5 Max Studio или M5 Pro Mac mini.
Вне стандартного набора бенчмарков я пробовал локальное vibe coding на Studio — впервые для меня. По совету нескольких людей я установил LM Studio Bionic и модель Qwen 3.8 27B.
В плане программирования я едва знаю базовый HTML и CSS, чтобы править шаблоны, но желание учиться всегда перевешивало умение. Виновата СДВГ, нехватка времени или что‑то в голове — не важно.
Использование M5 Ultra Mac Studio и LM Studio Bionic для запуска полностью локальной модели, способной кодить, оказалось самым интересным опытом с новой техникой за долгое время. Я говорю это как человек, который в целом скептически относится к генеративному ИИ.
Но есть причина, по которой vibe coding стал популярным в последние год-два. Если вы умеете четко сформулировать, чего хотите, можно сделать действительно полезные вещи, которые работают.
Я уже почти пятнадцать лет веду подкаст о книгах и занимаюсь нашей бухгалтерией — это побочный заработок к побочной работе. Годами это означало ручной ввод данных из выписок в таблицу, которую я сделал для отслеживания доходов, расходов и предполагаемых налогов. Это была слишком малая задача, чтобы платить за QuickBooks навсегда — софт делает слишком много лишнего. Это та задача, которая постоянно раздражает, но случается достаточно редко, чтобы никогда не доходить до ее решения.
Сначала я попросил модель Qwen написать скрипт на Python для конвертации PDF выписок в таблицы и их форматирования/сортировки по нужной мне логике. Затем я сделал веб‑приложение, чтобы можно было просто загружать будущие выписки, а не возиться с LLM или Python‑скриптом.
Я испытываю смешанные чувства, но неоспоримо приятно за пару вечеров сделать маленькую программу для решения своей персональной проблемы. И в этом случае можно сделать это на домашнем железе, данные не покидают ваши устройства, а потребление энергии меньше, чем у одной ПК‑видеокарты.
Я, наверное, мог бы решить проблему за тот же день, потратив пару долларов на облачные токены, но отправлять годы финансовых данных в Anthropic или куда‑то еще я не мог себе позволить морально. Так я и поступил.
Модель Qwen 3.8 27B — «open‑weight», выпущена под лицензией Apache 2.0, так что нет ограничений на использование. У нее есть разные «квантизации» (проще говоря, жертва точностью в обмен на меньший размер), что позволяет запускать ее на маках с разным объемом ОЗУ. Я бы сказал, что 32 ГБ — минимум для достаточно компетентной 4K‑квантизации с небольшим окном контекста для очень маленьких проектов или узких исправлений, но 64 ГБ — лучшая цель для системы с большим окном контекста и достаточным объемом памяти, чтобы одновременно использовать Mac как обычный компьютер.
Используя 4K‑квантизацию по умолчанию в LM Studio Bionic на macOS 27.0, мой повседневный M2 Mac Studio выдавал примерно 18–20 токенов в секунду на примере запроса о разворачивании нового веб‑проекта. Framework Desktop (на базе платформы Strix Point Ryzen AI Max+, популярной среди энтузиастов локального ИИ из‑за большого пула быстрой унифицированной памяти) выдал примерно те же 18–20 токенов в секунду на том же запросе, работая под Ubuntu 26.06 и бэкендом AMD ROCm.
Такая скорость токенов в секунду вовсе не ужасна: модель генерирует текст примерно с той же скоростью, с какой я могу его читать. Но для более длинного проекта по разработке (особенно если включен режим «reasoning», позволяющий боту сгенерировать много промежуточных рассуждений перед выбором курса действий) приходится много ждать, и скорость токенов в секунду начинает замедляться по мере увеличения окна контекста.
M5 Max Mac Studio выдавал примерно 31 токен в секунду на том же запросе. M5 Ultra выдает чуть более 50. (Именно поэтому Mac mini с M5 Pro менее удобен для такой работы даже при 64 ГБ ОЗУ — у него вдвое меньше пропускной способности памяти, чем у M5 Max, и эти нагрузки наиболее чувствительны именно к пропускной способности.)
Оба чипа Mac Studio реально пригодны для такой работы, если ваши амбиции скромны и вы готовы методично отлаживать и исправлять ошибки. Агент почти всегда сначала делает что‑то не так, и много времени при vibe coding уходит на доведение функций до ума, исправление за исправлением.
Версия Mac Studio Ultra остается нишевым продуктом для небольшой аудитории: людей, готовых потратить тысячи долларов и желающих работать с моделями ИИ локально, которые согласны на хорошие, но не ультра‑передовые скорости, и не хотят платить OpenAI, Anthropic или кому‑то еще за токены, которые они сожгут в экспериментальных задачах или при загрузке и редактировании большого кода. Такая аудитория существует. Почти вопреки себе, я оказался среди нее. Писать код для хобби на адекватных скоростях, не отправляя данные наружу, — искренне весело и освобождает. Жаль только, что я сделал это открытие как раз в момент, когда Apple подняла цены на 25 процентов и больше.