Архивный материал Mozilla (апрель 2021 г.). Указанные версии, результаты и планы относятся к публикации источника. Первоисточник.
Устранение гонок данных в Firefox — технический отчет Кристиан Холлер, Ария Бингесснер, Крис Райт
Мы успешно задеплоили ThreadSanitizer в проекте Firefox, чтобы устранить гонки данных в оставшихся компонентах на C/C++. В процессе мы нашли несколько значимых ошибок и можем с уверенностью сказать, что влияние гонок данных на корректность программ часто недооценивают. Мы рекомендуем всем многопоточным проектам на C/C++ применять инструмент ThreadSanitizer для повышения качества кода.
ThreadSanitizer (TSan) — это инструмент, реализующий во время компиляции инструментирование для обнаружения гонок данных в соответствии с моделью памяти C/C++ на Linux. Важно отметить, что такие гонки данных считаются неопределенным поведением в спецификации C/C++. Компилятор, исходя из этого, свободен предполагать, что гонок данных не происходит, и выполнять оптимизации исходя из этого предположения. Выявлять ошибки, вызванные такими оптимизациями, может быть сложно, а гонки данных часто проявляются прерывисто из-за планирования потоков.
Без инструмента вроде ThreadSanitizer даже самые опытные разработчики могут тратить часы на поиски такой ошибки. С ThreadSanitizer вы получаете подробный отчет о гонке данных, который часто содержит всю информацию, необходимую для исправления проблемы.
Одно важное свойство TSan заключается в том, что при корректном разворачивании обнаружение гонок данных не дает ложноположительных срабатываний. Это чрезвычайно важно для принятия инструмента, поскольку разработчики быстро теряют доверие к инструментам, которые дают неопределенные результаты.
Как и другие санитайзеры, TSan встроен в Clang и может использоваться с любой современной цепочкой инструментов Clang/LLVM. Если ваш проект на C/C++ уже использует, например, AddressSanitizer (который мы также настоятельно рекомендуем), развертывание ThreadSanitizer с точки зрения toolchain будет очень простым.
Несмотря на то, что ThreadSanitizer — хорошо продуманный инструмент, в ходе разворачивания в Mozilla нам пришлось преодолеть множество сложностей. Наиболее значимая проблема заключалась в том, что крайне трудно доказать, что гонки данных действительно вредны и влияют на повседневное использование Firefox. В частности, часто упоминался термин «безвредные» гонки данных. Безвредные гонки признают, что конкретная гонка действительно существует, но предполагают, что у нее нет отрицательных побочных эффектов.
Хотя безвредные гонки действительно существуют, мы обнаружили (в согласии с предыдущими работами по этой теме), что гонки данных очень легко неверно классифицировать как безвредные. Причины очевидны: сложно рассуждать о том, какие оптимизации компилятор может и будет применять, а подтверждение того, что конкретная «безвредная» гонка действительно безвредна, требует анализа ассемблерного кода, который в конце концов генерирует компилятор.
Разумеется, эта процедура часто занимает гораздо больше времени, чем простое исправление самой гонки данных, и при этом не является защищенной в будущем. В результате мы решили, что окончательной целью должна быть политика «нет гонок данных», которая объявляет даже безвредные гонки нежелательными из-за риска неверной классификации, времени, требуемого на расследование, и потенциальных рисков от будущих компиляторов (с лучшими оптимизациями) или платформ (например, ARM).
Однако было ясно, что установление такой политики потребует много работы как с технической стороны, так и в части убеждения разработчиков и менеджмента. В частности, мы не могли рассчитывать на выделение большого количества ресурсов на исправление гонок данных без явного влияния на продукт. Здесь пригодился механизм подавлений (suppression list) в TSan.
Мы понимали, что нужно остановить приток новых гонок данных и одновременно сделать инструмент пригодным в работе, не исправляя все унаследованные проблемы сразу. Список подавлений (в частности, версия, встроенная в Firefox) позволил нам временно игнорировать уже зафиксированные гонки и в итоге запустить сборку Firefox с TSan в CI, которая автоматически предотвращала регрессии. Конечно, уязвимости безопасности требовали специальной обработки, но обычно их было легко распознать (например, гонки на небезопасных для потоков указателях) и быстро исправить без подавлений.
Чтобы понять эффект нашей работы, мы вели внутренний список самых серьезных гонок, которые обнаружил TSan (те, которые имели побочные эффекты или могли вызывать краши). Эти данные помогли убедить разработчиков, что инструмент облегчает их жизнь, и одновременно обосновать проделанную работу перед менеджментом.
Кроме качественных данных, мы также провели количественный анализ: рассмотрели все баги, найденные за год, и их классификацию. Из 64 багов, которые мы изучили, 34% были классифицированы как «безвредные», 22% как «влиятельные» (остальные не были классифицированы).
Мы ожидали некоторой доли неверно классифицированных безвредных проблем, но хотели понять: представляют ли безвредные проблемы риск для проекта? Предположив, что все эти проблемы действительно не влияют на продукт, тратим ли мы много ресурсов на их исправление? К счастью, мы обнаружили, что большая часть таких исправлений была тривиальной и/или улучшала качество кода.
Тривиальные исправления в основном заключались в превращении неатомарных переменных в атомарные (20%), добавлении постоянных подавлений для upstream-проблем, которые мы не могли исправить сразу (15%), или удалении чрезмерно усложненного кода (20%). Только 45% исправлений классифицированных как безвредные требовали более сложного патча (то есть дифф был больше, чем несколько строк, и не был просто удалением кода).
Мы пришли к выводу, что риск того, что безвредные проблемы станут значительным потребителем ресурсов, не является проблемой и приемлем с учетом общих преимуществ для проекта.
Как уже упоминалось, TSan не генерирует ложноположительных отчетов о гонках данных при правильном разворачивании, что включает инструментирование всего кода, загружаемого в процесс, и избегание примитивов, которые TSan не понимает (например, атомарных барьеров — fences). Для большинства проектов эти условия тривиальны, но для крупных проектов, таких как Firefox, требуется немного больше работы. К счастью, эта работа в основном свелась к нескольким строкам в надежной системе подавлений TSan.
Инструментировать весь код Firefox в настоящее время невозможно, потому что он использует разделяемые системные библиотеки, такие как GTK и X11. К счастью, TSan предлагает функцию called_from_lib, которую можно использовать в списке подавлений для игнорирования вызовов, происходящих из этих общих библиотек. Другим крупным источником неинструментированного кода оказались флаги сборки, которые не передавались должным образом, что особенно проблематично для кода на Rust (см. раздел о Rust ниже).
Что касается неподдерживаемых примитивов, то единственной проблемой, с которой мы столкнулись, была нехватка поддержки для барьеров (fences). Большинство барьеров возникало из идиомы атомарного подсчета ссылок и могло быть тривиально заменено на атомарную загрузку в сборках с TSan. К сожалению, барьеры фундаментальны для дизайна крейта crossbeam (основной библиотеки конкуренции в Rust), и единственным решением здесь стала подавление.
Мы также обнаружили известное ложноположительное срабатывание в обнаружении дедлоков, которое, однако, очень легко определить и которое никак не влияет на обнаружение/отчетность о гонках данных. Коротко: любой отчет о дедлоке, в котором участвует только один поток, скорее всего — это ложноположительное срабатывание.
Единственная истинная ложноположительная ситуация, которую мы обнаружили, оказалась редкой ошибкой в самом TSan и была исправлена в инструменте. Тем не менее разработчики неоднократно утверждали, что тот или иной отчет обязательно ложноположительный. Во всех этих случаях оказывалось, что TSan был прав, а проблема была очень тонкой и трудно объяснимой. Это в очередной раз подтверждает, что нам нужны такие инструменты, как TSan, чтобы помочь устранить этот класс ошибок.
В настоящее время в списке багов, выявленных TSan, около 20 багов. Мы все еще работаем над исправлениями некоторых из них и хотим выделить несколько особенно интересных/влиятельных.
Битовые поля — удобный способ экономить место при хранении множества небольших значений. Например, вместо 30 булевых полей, занимающих 240 байт, их можно упаковать в 4 байта. В большинстве случаев это работает нормально, но у этого есть один неприятный побочный эффект: разные данные начинают алиаситься. Это значит, что доступ к «соседним» битовым полям фактически обращается к одной и той же памяти, а значит — потенциальная гонка данных.
На практике это означает, что если два потока записывают в два соседних битовых поля, одна из записей может потеряться, поскольку обе операции записи фактически являются операциями чтение‑изменение‑запись всех битовых полей.
Если вы знакомы с битовыми полями и осознанно думаете о них, это может быть очевидно, но когда вы просто пишете myVal.isInitialized = true, вы можете не думать или даже не подозревать, что обращаетесь к битовому полю.
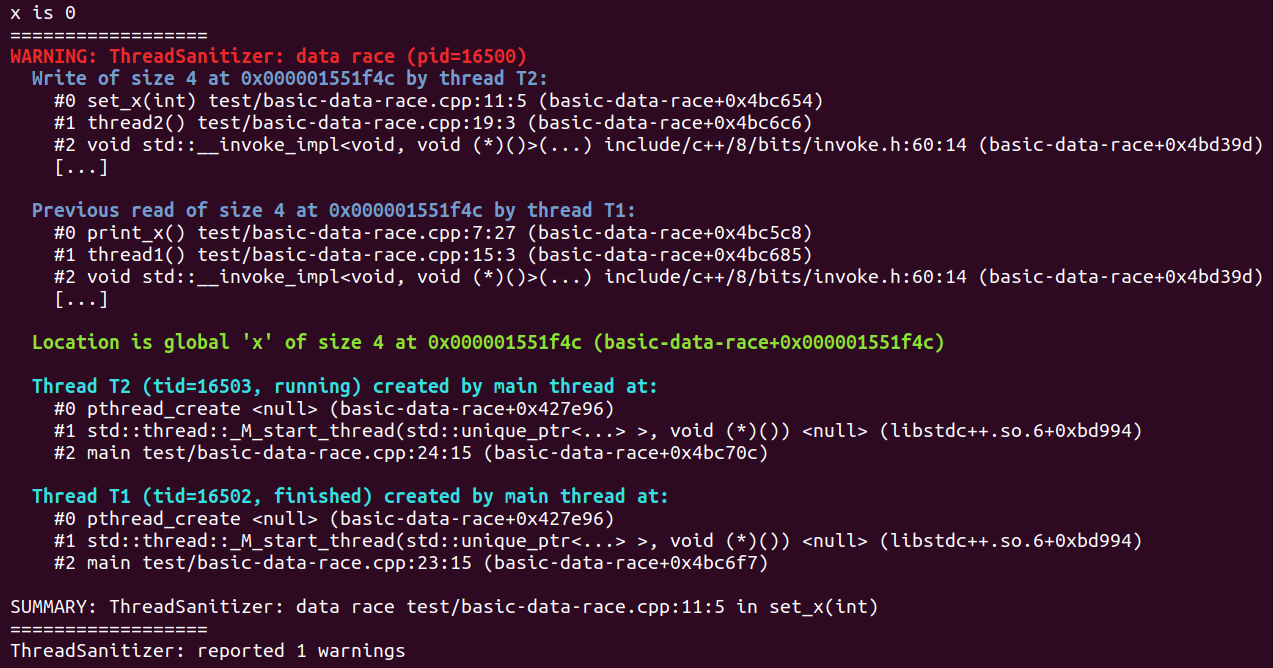
У нас было много случаев этой проблемы. Рассмотрим баг 1601940 и его (сокращенный) отчет о гонке: Когда мы впервые увидели этот отчет, он сбил с толку, потому что два спорящих потока затрагивали, казалось бы, разные поля (mAsyncTransformAppliedToContent vs. mTestAttributeAppliers). Однако, как выяснилось, эти два поля на самом деле являются смежными битовыми полями в классе.
Это вызывало прерывистые ошибки в нашем CI и стоило сопровождающему этому коду разработчику времени. Мы считаем этот баг особенно интересным, потому что он демонстрирует, как трудно диагностировать гонки данных без соответствующих инструментов, и мы нашли другие примеры этой проблемы (гонка запись/запись в битовые поля) в кодовой базе. Один из таких случаев имел потенциал привести к загрузке неверного кэш-содержимого из сети — еще одна трудно отлаживаемая ситуация, особенно когда она прерывиста и потому не всегда воспроизводима.
Мы столкнулись с этим настолько часто, что в итоге ввели макрос MOZ_ATOMIC_BITFIELDS, который генерирует битовые поля с атомарными методами load/store. Это позволило быстро исправлять проблемные битовые поля для сопровождающих каждого компонента без необходимости перерабатывать их типы.
Мы также нашли несколько случаев, когда компоненты, изначально задуманные как однопоточные, случайно использовались несколькими потоками, например баг 1681950:
Сама гонка в этом случае довольно простая: мы спорим при обращении к одному и тому же файлу через stat64, и понимание отчета не было проблемой. Однако, как видно из одного фрейма, этот вызов исходит из PreferencesWriter, который отвечает за запись изменений в файл prefs.js, центральное хранилище предпочтений Firefox.
Не предполагается, чтобы это вызывалось одновременно из нескольких потоков, и мы полагаем, что это могло привести к повреждению prefs.js. В результате при следующем запуске файл мог не загрузиться и быть отброшен (сброшен к настройкам по умолчанию). За годы у нас было немало отчетов о том, что этот файл «таинственно» теряет пользовательские предпочтения, но мы не могли найти причину. Сейчас мы считаем, что этот баг по крайней мере частично отвечает за такие потери.
Мы считаем, что это особенно хороший пример по двум причинам: это была гонка, имевшая более вредные последствия, чем просто краш, и она выявила более крупную логическую ошибку — использование компонента вне его изначальных параметров дизайна.
В нескольких случаях мы сталкивались с шаблоном поведения на границе «безвредного», которому, по нашему мнению, стоит уделить дополнительное внимание: сознательное чтение значения в условиях гонки, а затем последующая проверка, которая якобы корректирует ситуацию. Например, код вида: (пример опущен автором статьи) См., например, этот случай в SQLite.
Пожалуйста, не делайте так. Такие паттерны очень хрупки, и в конечном счете это неопределенное поведение, даже если в общем они обычно работают. Пишите правильный атомарный код — вы обычно обнаружите, что производительность при этом вполне приемлема.
Еще одна сложность, которую нам пришлось решить при развертывании TSan, связана с тем, что часть нашей кодовой базы теперь написана на Rust, и поддержка санитайзеров для Rust значительно менее зрелая. Это означало, что значительная часть времени при bringup у нас весь Rust-код была подавлена, пока инструментальная поддержка развивалась.
Нас прежде всего волновало не большое количество гонок в Rust-коде, а то, что гонки в C++ могли маскироваться при прохождении через Rust. На самом деле мы настоятельно рекомендуем писать новые проекты полностью на Rust, чтобы вообще избежать гонок данных.
Особенно сложной была необходимость перекомпилировать стандартную библиотеку Rust с инструментированием TSan. На nightly есть нестабильная опция -Zbuild-std, которая позволяет это сделать, но она все еще с огрехами.
Наше главное препятствие с build-std заключалось в том, что она несовместима с вендорными окружениями сборки, которые использует Firefox. Исправить это непросто, потому что инструменты cargo для патчей зависимостей не рассчитаны на воздействие только на подграф (то есть только на std, а не на ваш собственный код). Пока что мы обошли это, поддерживая небольшой набор патчей поверх rustc/cargo, которые работают достаточно хорошо для Firefox, но требуют дополнительной работы для попадания upstream.
Однако, с тем что build-std был модифицирован и заработал для нас, мы смогли инструментировать наш Rust-код и с радостью обнаружили, что проблем оказалось очень мало! Большинство обнаруженных вещей были гонками в C++, которые проходили через некоторый Rust-код и потому ранее были скрыты нашими общими подавлениями.
Мы, однако, нашли две чисто Rust-гонки: Первый — баг 1674770, который был в библиотеке parking_lot. Эта библиотека Rust предоставляет примитивы синхронизации и другие инструменты конкурентности и пишется/поддерживается экспертами. Мы не исследовали глубоко влияние, но проблема заключалась в слишком слабых порядках атомных операций и была быстро исправлена авторами. Это еще один пример того, насколько трудно писать безошибочный конкурентный код.
Второй — баг 1686158, в коде программной оболочки OpenGL в WebRender. Там поддерживалось вручную общедоступное изменяемое состояние с использованием низкоуровневых атомиков, но один из полей забыли сделать атомарным. Это было достаточно просто исправить.
В целом Rust, похоже, оправдывает одну из своих исходных целей: позволять писать более конкурентный код безопасно. И WebRender, и Stylo очень большие и широко многопоточны, но имеют минимальные проблемы с потоками. Те проблемы, которые мы нашли, были ошибками в реализациях низкоуровневых и явно unsafe абстракций многопоточности — и эти ошибки были просты в исправлении.
Это контрастирует с многими нашими гонками в C++, которые часто возникали из случайного доступа к объектам с разных потоков с неочевидными семантиками, и требовали нетривиальной переработки кода.
Гонки данных — недооцененная проблема. Из-за их сложности и прерывистости мы часто испытываем трудности с их идентификацией, локализацией причины и оценкой воздействия. Во многих случаях это также трудоемкий процесс, который тратит ценные ресурсы. ThreadSanitizer доказал свою эффективность не только в локализации гонок данных и предоставлении достаточной отладочной информации, но и в практичности применения в проекте такого масштаба, как Firefox.
Мы хотели бы поблагодарить авторов ThreadSanitizer за инструмент и в частности Дмитрия Выукова (Dmitry Vyukov, Google) за помощь с некоторыми сложными, специфичными для Firefox случаями при разворачивании.
Кристиан — технический лидер Firefox и старший инженер в Mozilla.
Спасибо! Пожалуйста, проверьте вашу почту, чтобы подтвердить подписку. Если вы ранее не подтверждали подписку на новостную рассылку, связанную с Mozilla, возможно, вам придется это сделать. Проверьте почтовый ящик или папку со спамом на наличие письма от нас.
Вопросы читателей (содержимое комментариев) Почему 30 булевых значений заняли бы 240 байт? Это по 8 байт на каждую. Я обычно ожидал бы, что они займут по 1 байту каждая, то есть 30 байт всего. При использовании базового 32‑битного int (как в старых версиях Visual C++) это было бы 4 байта на элемент. Может ли для каждого булева значения выделяться полноценное поле размером указателя? Это звучит безумно.
Есть ли план или график по рефакторингу всего кода в Rust?
Я не совсем понимаю, почему нужен фикс MOZ_ATOMIC_BITFIELDS. Согласно упомянутой модели памяти C++, «ячейкой памяти» считается «самая большая непрерывная последовательность битовых полей ненулевой длины». Поэтому разделение битовых полей фиктивными нулевой длины членами могло бы сделать каждое битовое поле отдельной ячейкой памяти и избежать гонок. Единственное, что приходит на ум — компилятор может решить выделить каждое битовое поле в отдельный байт, тем самым сводя на нет экономию по размеру.
Также в комментариях указывают, что оба gcc и clang поддерживают statement expressions, и можно было бы реализовать потокобезопасную инициализацию через static bool unused = ({ /* код инициализации */ }); или воспользоваться особенностью C++11 — статической инициализацией с гарантией потокобезопасности. В современных реалиях писать корректную версию проще.
Комментарии к статье закрыты.