Архивный материал Mozilla (март 2026 г.). Указанные версии, результаты и планы относятся к публикации источника. Первоисточник.
Под капотом: ИИ, который стоит за функцией Shake to Summarize в Firefox
Недавно мы выпустили функцию в мобильном приложении Firefox для iOS под названием «Shake to Summarize». Реакция была крайне положительной — функция получила почётное упоминание в списке лучших изобретений 2025 года по версии Time Magazine.
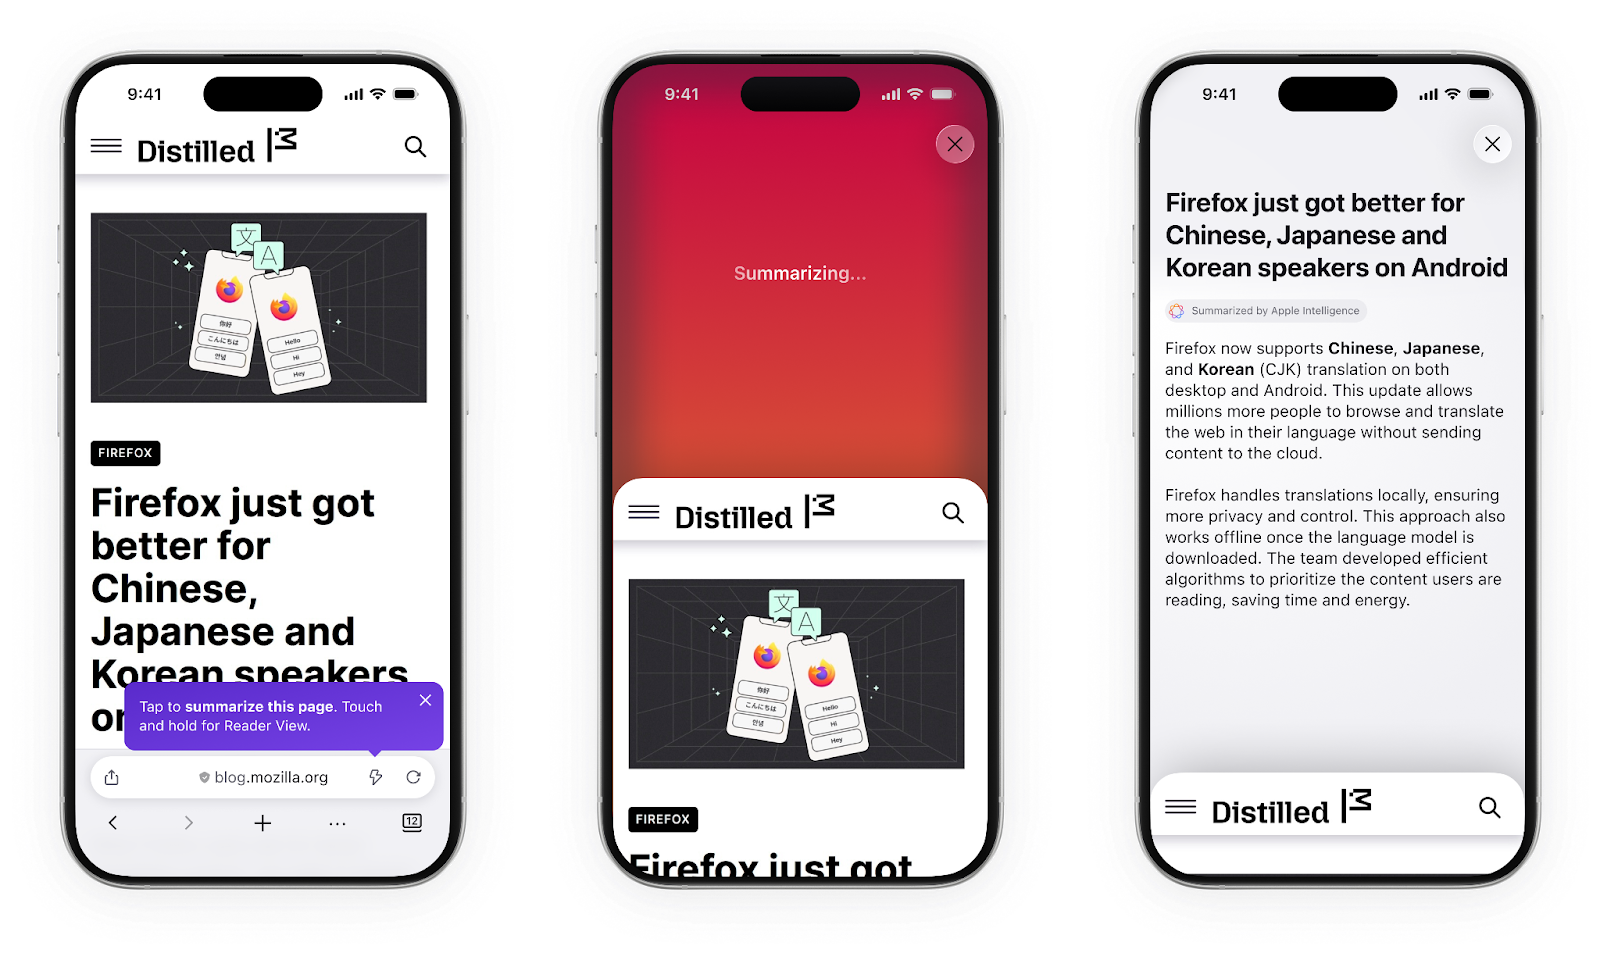
Для тех, кто не знаком с Shake to Summarize: всё именно так, как звучит в названии — когда вы просматриваете веб-страницу, можно встряхнуть телефон, чтобы сгенерировать короткое резюме содержимого страницы.
Жест забавный, функция полезная, и всё это кажется простым и естественным.
С технической точки зрения приложение работает так, как вы ожидаете: при обнаружении встряхивания (или нажатия на значок молнии) мы получаем содержимое веб-страницы, передаём его в большую языковую модель для суммирования и затем возвращаем результат пользователю.
Но ландшафт LLM настолько обширен, что при выходе даже относительно простой функции на рынок приходится учитывать множество факторов. В этой статье мы обсудим подход к выбору модели. Разработку подсказок и тестирование качества оставим для будущей публикации.
В настоящее время доступно много LLM, и новые релизы появляются почти каждую неделю. Каждый релиз сопровождается набором бенчмарков, демонстрирующих превосходство модели по той или иной метрике. Темп разработки быстрый, и на повышение показателей потрачены миллиарды долларов. Но что эти метрики означают на практике? В конце концов мы создаём продукт для пользователей. Для нас самая важная метрика — «насколько полезны резюме, которые генерирует модель?» — показателем, который плохо коррелирует с бенчмарками. Чтобы выбрать лучшую модель для нашего приложения, нужно проводить собственные тесты.
Для нас лучшая модель должна была превосходить по нескольким критериям:
- Во-первых, качество резюме. В конце концов, в этом весь смысл.
- Во-вторых, скорость. Модель должна возвращать резюме относительно быстро. Если на генерацию резюме уходит столько же времени, сколько на чтение статьи — мы проиграли.
- В-третьих, стоимость. Поскольку мы не взимаем плату за использование функции Shake to Summarize, расходы на вывод полностью ложатся на нас.
- Наконец, открытый исходный код. Поддержка open source — одна из ключевых ценностей Mozilla. Поэтому, когда возможно, мы предпочитаем использовать модели с открытым исходным кодом (в данном случае мы соглашались на открытые веса).
Учитывая вышеперечисленное, для первоначальной оценки мы отобрали следующие модели: Mistral Nemo, Mistral Small, Jamba 1.5 mini, Gemini flash 2.0 flash и Llama 4 Maverick — все они размещались в Vertex AI. Примечание: проект начался в начале 2025 года.
Стандартные метрики оценки резюме, такие как BLEU и ROUGE, опираются на совпадение токенов и плохо коррелируют с человеческими суждениями. Поэтому мы решили использовать в роли судьи LLM (GPT-4o), чтобы оценить кандидатов. Каждая модель сгенерировала резюме для одного и того же набора веб-страниц, а затем LLM-судья оценивал каждое резюме по следующим критериям:
- Связность: читается ли резюме логично и понятно как самостоятельный текст?
- Последовательность: точна ли информация в резюме и соответствует ли источнику? Есть ли галлюцинации?
- Актуальность: фокусируется ли резюме на наиболее важном содержимом документа?
- Плавность: грамматично ли корректно, плавно и хорошо ли написано резюме?
Чтобы получить одно сопоставимое значение, мы затем усреднили эти оценки.
По результатам анализа видно, что Google Gemini 2.0 Flash, Meta Llama 4 Maverick и Mistral Small демонстрируют лучшие результаты — при этом Gemini стабильно лидирует. Три лучшие модели примерно эквивалентны на коротких отрывках до примерно 2000 токенов (примерная длина средней веб-страницы), но по мере увеличения длины текста их производительность расходится — особенно для текстов свыше 5000 токенов*.
*Отметим, что частично из-за снижения производительности мы суммируем только страницы короче этого порога в 5000 токенов.
Для оценки скорости мы рассмотрели два показателя: время до первого токена (то есть как долго ждать, прежде чем модель начнёт генерировать ответ) и количество токенов в секунду (общее количество сгенерированных токенов, делённое на общее время генерации, включая время кодирования).
По обоим тестам Mistral-Small и Gemini-2.0-flash оказались явными лидерами. Обе модели быстрее начинают генерацию и производят токены значительно быстрее, чем другие протестированные модели.
На безсерверных инстансах Vertex AI, по состоянию на ноябрь 2025 года, стоимость входных токенов для наших трёх ведущих моделей выглядит следующим образом. (Здесь приводится общий комментарий о ценообразовании Vertex AI.)
Очевидно, что Mistral Small превосходит по соотношению качество/производительность/цена: стоимость входного токена у неё составляет примерно одну треть или меньше по сравнению с двумя другими моделями (а именно там сосредоточена основная часть нашего потребления токенов).
Наш главный приоритет — создание отличного пользовательского опыта. Мы также считаем, что программное обеспечение с открытым исходным кодом — неотъемлемая часть здорового интернета. Когда мы можем поддержать open source и при этом обеспечить наилучшее качество, мы это делаем.
В этой категории Llama4 Maverick и Mistral Small выступают лучше остальных. Хотя ни одна из них не полностью open source (не опубликованы тренировочный код или данные), обе имеют открытые веса и либеральные политики использования. Gemini 2.5 Flash, напротив, является проприетарной моделью.
Учитывая все вышеперечисленное, мы решили использовать Mistral-Small для работы функции: она быстрая, недорогая, имеет открытые веса и выдаёт качественные резюме. Что здесь не нравится?
После выбора модели мы итеративно работали над подсказкой, чтобы обеспечить лучший опыт (см. будущую публикацию: Shake to Summarize: Prompt Engineering), и выпустили решение в сентябре 2025 года.
Этот проект стал нашим ранним опытом интеграции возможностей LLM прямо в браузер. Процесс выбора моделей, который мы разработали здесь, помог проложить путь для последующих интеграций ИИ в Firefox. В частности, скоро выпускаемое Smart Window требовало выбора не одной, а нескольких моделей для работы — давая пользователям больше контроля над опытом. В процессе мы убедились, что «лучшая» модель — это не та, что имеет самые высокие бенчмарк-показатели, а та, что соответствует контексту использования — задаче, бюджету и приверженности Mozilla принципам open source.
Веб должен оставаться анонимным по умолчанию
Познакомьтесь с Kit — вашим спутником для новой эпохи интернета
Эта карта показывает самый важный актив, который сейчас нужен компаниям с венчурным финансированием
Mozilla представляет Firefox Enterprise
Firefox сотрудничает с Anschutz Entertainment Group в Uber Arena и Uber Eats Music Hall в Берлине