Портирование кроссплатформенного GUI-приложения на Rust
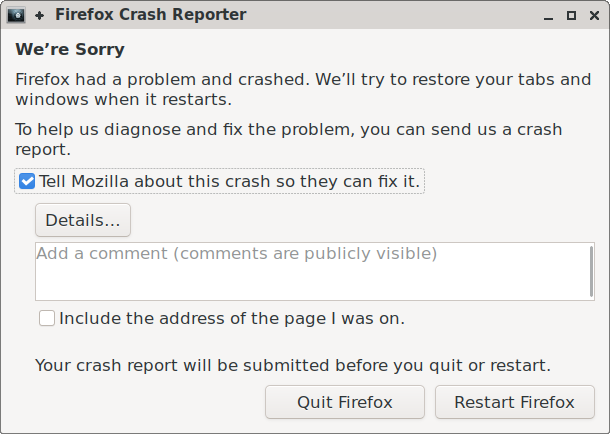
Сборщик отчетов о падениях Firefox, надеюсь, не то, с чем большинство пользователей сталкивается часто. Тем не менее это очень важный компонент Firefox, поскольку он предоставляет представление о самых заметных ошибках: тех, которые приводят к аварийному завершению основного процесса. Эти ошибки дают худший пользовательский опыт (поскольку всё приложение должно закрыться), поэтому их исправление — крайне высокий приоритет. Другие типы падений, например падения содержимого (вкладки), браузер может обработать и корректно сообщить о них, иногда так, что пользователь даже не узнает о случившемся. Но когда основной процесс браузера останавливается, нам нужно отдельное приложение, которое соберет информацию о падении и взаимодействует с пользователем.
В этом материале описан подход, который мы использовали для переписывания сборщика отчетов о падениях на Rust. Мы обсуждаем мотивы этого переписывания, что делает сборщик уникальным приложением, архитектуру, которую мы применили, и некоторые детали реализации.
Хотя корректная обработка падений основного процесса важна, сборщик отчетов не получал значительного развития в течение длительного времени (помимо работ по обеспечению надежной доставки отчетов и телеметрии). Он долгое время застрял в локальном максимуме «достаточно хорошо» и «страшно поддерживать»: у него три отдельных GUI-реализации (для Windows, GTK+ для Linux и macOS), вспомогательный код, абстрагирующий несколько вещей (в основном на C++ и Objective-C для macOS), бинарный blob, полученный устаревшими средствами разработки Apple, и отсутствует тестовый набор. Из-за этого накопился бэклог функций и улучшений, которые не были реализованы.
В последнее время у нас было несколько успешных шагов по снижению частоты падений (включая как крупные достижения, так и множество мелких исправлений), и сборщик отчетов работал достаточно хорошо в этот период. Тем не менее мы достигли переломного момента, когда улучшение сборщика дало бы ценную возможность дальше снижать частоту падений. По ранее описанным причинам улучшать текущую базу кода сложно и рискованно, поэтому мы решили переписать приложение, чтобы проще работать с бэклогом функций и улучшать отчеты о падениях.
Как и многие компоненты Firefox, мы решили использовать Rust для этого переписывания, чтобы получить более надежную и удобную для сопровождения программу. Помимо часто упоминаемой безопасности памяти, типовая система Rust и стандартная библиотека облегчают рассуждения о коде, обработку ошибок и разработку кроссплатформенных приложений, делая эти задачи более надежными и полными.
Сборщик отчетов имеет ряд особенностей, которые делают его довольно уникальным, особенно по сравнению с другими компонентами, портированными на Rust. Во-первых, это отдельная, самостоятельная программа; практически никакие другие компоненты Firefox не используются таким образом. Firefox сам по себе запускает множество процессов как средство сандбокса и защиты от падений, однако эти процессы общаются друг с другом и имеют доступ к одной и той же базе кода.
У сборщика отчетов уникальное требование: он должен использовать как можно меньше кода Firefox, в идеале — вовсе не использовать! Мы не хотим, чтобы он полагался на код, который может содержать ошибки и вызвать падение самого сборщика. Полностью независимая реализация обеспечивает, что когда происходит падение основного процесса, причина этого падения не повлияет на функциональность сборщика.
Сборщик отчетов также обязательно имеет GUI. Это само по себе не отделяет его от других компонентов Firefox, но мы не можем использовать кроссплатформенные возможности рендеринга, которые предоставляет Firefox! Поэтому нам нужно реализовать кроссплатформенный GUI независимо от Firefox. Можно было бы подумать о готовой кроссплатформенной GUI-библиотеке для Rust, однако у нас есть несколько причин этого не делать.
- Мы хотим минимизировать использование внешнего кода: для повышения надежности сборщика (что критично) он должен быть как можно проще и более аудируем.
- Firefox включает все зависимости в дерево (vendors in-tree), поэтому мы неохотно вносим крупные зависимости (GUI-библиотеки обычно довольно объемны).
- Есть лишь несколько сторонних crate, которые обеспечивают нативный вид и ощущение ОС (или действительно используют нативные GUI-API); важно, чтобы сборщик выглядел нативно, был знаком пользователям и поддерживал возможности доступности.
Таким образом, сторонние кроссплатформенные GUI-библиотеки не являются предпочтительным вариантом.
Эти требования значительно сужают допустимые подходы.
Чтобы сделать сборщик более поддерживаемым (и упростить добавление новых функций в будущем), мы хотели свести к минимуму платформенно-специфичный код. Мы можем добиться этого, используя простую модель UI, которую можно преобразовать в нативный GUI-код для каждой платформы. Каждая реализация UI должна предоставить два метода (над произвольными платформенно-специфичными &self данными):
- run_loop: интерфейс понятен — реализация UI принимает модель Application (о ней ниже) и запускает приложение, блокируя выполнение до завершения приложения. К счастью, целевые платформы в целом имеют похожие допущения насчет потоков: UI выполняется в одном потоке и обычно запускает цикл событий, который блокируется, ожидая новые события, пока не придет сигнал окончания работы.
- invoke: бывают случаи, когда нужно выполнить функцию в UI-потоке асинхронно (например, показать окно, обновить текстовое поле и т. п.). Поскольку run_loop блокирует, нам нужен метод invoke, который определяет, как это делать. Такая модель потоков упростит работу с платформенными GUI-фреймворками: все вызовы нативных функций будут происходить в одном потоке (в основном потоке) на протяжении жизни программы.
Пора уточнить, как будет выглядеть каждая реализация UI. Позже мы обсудим сложности для каждой платформы. Итого 4 реализации UI:
- Реализация для Windows с использованием Win32 API.
- Реализация для macOS с использованием Cocoa (AppKit и Foundation).
- Реализация для Linux с использованием GTK+ 3 (позже «+» был убран в GTK 4, далее я буду называть его «GTK»). Linux не предоставляет собственных GUI-примитивов, и мы уже поставляем GTK с Firefox на Linux, чтобы обеспечивать современный интерфейс, поэтому можем использовать его и для сборщика. Некоторые платформы, которые не поддерживаются Mozilla напрямую (например BSD), также используют реализацию на GTK.
- Тестовая реализация, которая позволит тестам подключаться к виртуальному UI и взаимодействовать с ним (симулировать действия и читать состояние).
Еще одна деталь перед детальным разбором: GUI сборщика сейчас довольно простой. Поэтому явной не-целью разработки было создание отдельного Rust GUI-crate. Мы хотели создать минимальную абстракцию, достаточную для нужд сборщика. Если в будущем понадобится больше контролов, мы добавим их в абстракцию, но не тратим время на покрытие всех возможных GUI-сценариев заранее.
Аналогично, мы старались избегать лишней разработки, допуская некоторые практические упрощения и встроенные частные случаи. Например, в нашей модели Button определен как элемент, содержащий произвольный элемент, но полноценная поддержка этого на Win32 или AppKit потребовала бы много кода, поэтому мы сделали специальный случай для Button, содержащего Label (это все, что нам сейчас нужно, и простой примитив, доступный на платформах). К счастью, подобных специальных случаев немного, и мы довольны тем немногим, что пришлось сделать.
Наша модель — декларативное структурирование концепций, в основном присутствующих в GTK. Поскольку GTK — зрелая библиотека с проверенными высокоуровневыми UI-концепциями, это сделало абстракцию подходящей и упростило реализацию на GTK. Например, самый простой способ компоновки в GTK (контейнеры и отступы/выровнивание для каждого элемента) достаточно для нашего GUI, поэтому мы используем похожие определения в модели. Заметьте, что такое «простое» определение компоновки в некоторой степени высокоуровневое и несколько усложняет реализации для macOS и Windows, но эта компромисса стоит удобства создания UI-моделей.
Тип верхнего уровня в нашей UI-модели — Application. Это просто: Application — это набор верхнеуровневых Windows (хотя у нашего приложения только одно окно) и флаг, указывающий, является ли текущая локаль справа-налево. Мы инспектируем ресурсы Firefox, чтобы использовать ту же локаль, которую использует Firefox, поэтому не полагаемся на настройки локали нативного GUI.
Как и ожидалось, каждое Window содержит один корневой элемент. Остальная модель состоит из нескольких обычных контейнерных и примитивных GUI-элементов:
- Window
- VBox и HBox (вертикальный и горизонтальный контейнеры)
- Label
- Button
- Textbox
- Progress
- Checkbox
- Image
Сборщику требуется лишь 8 типов GUI-элементов! И, по сути, Progress используется скорее как индикатор-загрузчик (spinner), а не для индикации реального прогресса, так что он не строго обязателен (но приятен визуально).
Rust явно не поддерживает объектно-ориентированную концепцию наследования, поэтому может возникнуть вопрос, как каждый GUI-элемент «расширяет» Element. Отношение в модели несколько абстрактно; реализованный Element выглядит примерно так: общий Element содержит ElementStyle с общими свойствами элементов (выровнивание, размер, отступы, видимость, состояние enabled), а ElementType — это enum, перечисляющий конкретные типы элементов как варианты.
Элементы модели предназначены для потребления реализациями UI; поэтому почти все поля имеют публичную видимость. Однако чтобы обеспечить отдельный интерфейс для построения элементов, мы определяем ElementBuilder<T>. Этот тип предоставляет методы, которые поддерживают инварианты и удобные сеттеры. Например, многие методы принимают impl Into<MemberType>, некоторые методы вроде margin() устанавливают сразу несколько значений (но можно быть более конкретным с margin_top()), и т. п.
Есть общий impl<T> ElementBuilder<T>, который предоставляет сеттеры для свойств ElementStyle, а каждый конкретный тип элемента может также предоставлять свой impl ElementBuilder<SpecificElement> с дополнительными свойствами, уникальными для этого типа.
Мы объединяем ElementBuilder<T> с макросом ui!. Этот макрос позволяет писать UI декларативно. Например, он позволяет записать структуру интерфейса компактно и иерархично. Реализация ui! довольно проста: первый идентификатор задает тип элемента и создается ElementBuilder<T>. Затем оставшаяся синтаксисоподобная форма вызова методов применяется к билдеру (который изменяется). Опционально, если указать блок в фигурных скобках, элемент имеет дочерние элементы; в этом случае макрос рекурсивно создаёт их и вызывает add_child на билдре с результатом. В итоге синтаксическое преобразование простое, но я считаю, что макрос — это не просто синтаксический сахар: он делает чтение и редактирование UI гораздо яснее, поскольку иерархия элементов представлена в синтаксисе. К минусам относится то, что автоматическое форматирование таких DSL-макросов недоступно, поэтому разработчикам нужно поддерживать приемлемое оформление вручную.
Теперь у нас есть модель и декларативный способ её создания. Но что насчет динамики во время выполнения? В примере выше видно, что на кнопку назначён on_click handler, а свойство Window.visible привязано к значению show_details, которое меняется при нажатии. Мы связываем эту декларативную модель с динамикой через простые примитивы привязки данных, с которыми могут взаимодействовать реализации UI.
Современные GUI-фреймворки (как для Rust, так и для других языков) часто строятся по архитектуре «разницы деревьев элементов» (подобно React), где код по сути функционален и без побочных эффектов, и предоставляет GUI как функцию от текущего состояния. Такой подход имеет свои преимущества: он упрощает сложные stateful изменения разметки, поощряет чистое разделение модели и представления и т. п. Однако мы не собираемся строить фреймворк, и наше приложение останется относительно простым, поэтому выгоды такого подхода не окупили бы дополнительные затраты на разработку. Наша реализация скорее близка к MVVM:
- модель — это описанная выше модель;
- представления — это различные реализации UI;
- viewmodel — это, если приглядеться, набор привязок данных.
Мы используем несколько типов для объявления динамических (изменяемых во время выполнения) значений. В нашем UI нужно поддержать несколько поведений:
- триггеры событий — что происходит при нажатии кнопки;
- синхронизированные значения, которые зеркально отражают и уведомляют обо всех изменениях у всех клонов;
- значения по запросу (on-demand), которые можно опросить для получения текущего значения.
Значения по запросу используются, например, чтобы получать содержимое текстбокса, вместо того чтобы реализовывать дебаунсинг в каждой UI-реализации. Возможно, реализовать дебаунсинг было бы несложно, но поддержка on-demand оказалась простым решением.
Для удобства мы создали тип Property, который объединяет ориентированные на значение поля. Property<T> может быть установлено либо как статическое значение (T), либо как синхронизированное значение (Synchronized<T>), либо как on-demand значение (OnDemand<T>). Для каждого из этих вариантов реализован From, поэтому методы билдера могут принимать impl Into<Property<T>>, что позволяет в декларации UI передавать любой поддерживаемый тип значения.
Мы не будем глубоко обсуждать реализацию (она предсказуема), но стоит отметить: все эти типы Clone, чтобы было просто делиться привязками данных: они используют Rc (нам не нужна потокобезопасность) и RefCell там, где требуется доступ к обратным вызовам.
В приведенном примере show_details — это Synchronized<bool>. Когда он меняется, реализации UI изменяют видимость связанного окна. Callback on_click у Button устанавливает синхронизированное значение в false, скрывая окно (примечание: в примере окно деталей не закрывают окончательно, его просто показывают и скрывают).
Ранее реализации привязок данных имели параметр времени жизни, который указывал, как долго валидны callbacks. Хотя это работало, это сильно усложняло код, особенно потому, что нельзя было корректно передать компилятору ковариантность времени жизни, поэтому приходилось использовать unsafe для трансмутации времен жизни (хотя это было инкапсулировано). Эти времена жизни распространялись и требовали сложной семантики в моделях, которые хранили поля Property.
Большая часть этого делалась, чтобы избежать клонирования значений в callbacks, но изменение типов на Clone и хранение callback-ов с ‘static временем жизни было оправданным, поскольку сделало код гораздо более поддерживаемым.
Внимательный читатель может вспомнить, что наша модель потоков предполагает взаимодействие с реализациями UI только в основном потоке. Это включает обновления привязок данных, так как реализации UI могли зарегистрировать свои callbacks! Хотя можно было бы выполнять всё в основном потоке, гораздо лучше по опыту делать как можно больше работы вне UI-потока, даже если мы не выполняем много блокирующих операций (но отправка отчетов о падениях будет блокирующей). Мы хотим, чтобы бизнес-логика по умолчанию выполнялась вне основного потока, чтобы UI никогда не зависал. Мы можем гарантировать это с помощью аккуратного проектирования.
Простейший способ гарантировать это — поместить всю бизнес-логику в один (не Clone, не Sync) тип (назовём его Logic) и конструировать UI и состояние UI (типа Property) в другом типе (назовём его UI). Затем можно переместить Logic в отдельный поток, чтобы исключить прямое взаимодействие UI с Logic и наоборот. Разумеется, нам иногда нужно общаться! Но нужно гарантировать, что такое общение всегда будет делегироваться потоку, владеющему значениями.
Это достигается созданием функции-очереди для каждого типа и хранением её в противоположном типе. Такая функция принимает boxed-функции для выполнения в потоке-владельце, получающие ссылку на хранимый тип (например, Box<dyn FnOnce(&T) + Send + ‘static>). Для UI-потока это просто метод invoke реализации UI. Поток Logic запускает цикл, который получает эти функции и выполняет их на owned-значении (мы передаем их через mpsc::channel). Теперь каждый тип может асинхронно вызвать методы другого с гарантией, что они будут выполнены в правильном потоке.
Ранее использовалась более сложная схема с thread-local storage и центральным типом, ответственным за создание потоков и делегирование функций. Но для такой простой задачи — двух потоков, делегирующих друг другу — мы смогли свести всё к самому необходимому, значительно упростив код.
Одним из приятных преимуществ переписывания стала возможность привести локализацию сборщика отчетов в соответствие с нашими современными инструментами. В почти всех других частях Firefox мы используем Fluent для локализации. Использование Fluent в сборщике делает опыт локализации более единообразным и предсказуемым: локализаторы не должны знать более чем одну систему локализации (сборщик был одним из последних держателей старой системы). В новом коде это оказалось очень просто, с небольшим дополнительным кодом для извлечения файлов локализации из установки Firefox при запуске сборщика. Если файлы локализации недоступны, сборщик использует встроенную резервную локаль en-US. Это важно для отдельного приложения, которое должно показать интерфейс даже после падения основного процесса.
Это обзор архитектуры и обмена данными между потоками, а не полный каталог платформенных UI-реализаций. Дополнительные детали GTK, Win32 и macOS приведены в инженерном разборе Mozilla за апрель 2024 года.