Архивный материал Mozilla (июнь 2022 г.). Указанные версии, результаты и планы относятся к публикации источника. Первоисточник.
Обучение эффективных моделей нейронного перевода для Firefox Translations
Машинный перевод — важный инструмент для расширения доступности веб-контента. Обычно люди используют облачных провайдеров для перевода веб-страниц. Современные модели нейронного машинного перевода (NMT) большие и часто требуют специализированного оборудования, например графических процессоров (GPU), чтобы выполнять инференс в реальном времени.
Если бы пользователи могли запускать компактную модель машинного перевода на процессоре своего локального компьютера без потери качества перевода, это помогло бы сохранить приватность и сократить расходы.
Проект Bergamot — это сотрудничество между Mozilla, Эдинбургским университетом, Карловым университетом в Праге, Шеффилдским университетом и Тартуским университетом при финансировании по программе исследований и инноваций Horizon 2020 Европейского союза. Он приносит машинный перевод в локальную среду, предоставляя небольшие, высококачественные NMT-модели, оптимизированные для CPU. Веб-расширение Firefox Translations использует достижения проекта Bergamot и обеспечивает локальные переводы в Firefox.
В этой статье мы обсудим компоненты, используемые для обучения наших эффективных NMT-моделей. Проект является открытым, поэтому вы можете попробовать его и обучить свою модель тоже!
Модели NMT обучаются для языковых пар, переводя с языка A на язык B. Конвейер обучения был спроектирован так, чтобы обучать модели перевода для языковой пары «от и до» — от настройки окружения до экспорта готовых к использованию моделей. Запуск конвейера полностью воспроизводим при одинаковом коде, оборудовании и конфигурационных файлах.
Сложность конвейера связано с требованием получить эффективную модель. Мы используем дистилляцию «учитель–студент» (Teacher-Student) для сжатия высококачественной, но ресурсоёмкой модели-учителя в эффективную модель-студента, оптимизированную для CPU, которая при этом сохраняет хорошее качество перевода. Мы подробнее объясняем это в разделе «Сжатие».
Конвейер включает множество шагов: компиляцию компонентов, загрузку и очистку наборов данных, обучение моделей-учителя, студента и обратной модели, декодирование, квантизацию, оценку и др. (подробнее ниже). Конвейер можно представить как ациклический ориентированный граф (DAG).
Рабочий процесс основан на файлах и использует автономные скрипты, которые читают данные с диска и записывают промежуточные и итоговые результаты обратно на диск.
Мы используем движок Marian Neural Machine Translation. Он написан на C++ и спроектирован для высокой скорости. Движок с открытым исходным кодом и используется многими университетами и компаниями, включая Microsoft.
Первая задача конвейера — обучить высококачественную модель, которую затем будет сложно сжать. Главная сложность на этом этапе — найти хороший параллельный корпус, содержащий переводы тех же предложений и в исходном, и в целевом языке, а затем применить соответствующие процедуры очистки.
Оказалось, что в интернете доступно много открытых параллельных наборов данных для машинного перевода. Самый интересный проект, агрегирующий такие наборы, — OPUS. Ежегодная конференция по машинному переводу (WMT) также собирает и распространяет некоторые наборы данных для соревнований, например WMT21 Machine Translation of News. Еще один источник корпуса для MT — проект Paracrawl.
Можно использовать любой набор данных с диска, но автоматизация загрузки данных из открытых ресурсов облегчает добавление новых языковых пар, и при расширении набора данных мы можем легко переобучить модель, чтобы воспользоваться дополнительными данными. Обязательно проверяйте лицензии открытых наборов данных перед использованием.
Большинство открытых наборов данных содержат некоторый шум. Хорошие примеры — сайты, собранные краулингом, и переводы субтитров. Тексты с веб-сайтов могут быть автоматическими переводами низкого качества или содержать неожиданный HTML, а субтитры часто являются свободными переводами, меняющими смысл текста.
В мире машинного обучения хорошо известно: если кормить модель мусором, получится мусор на выходе. Очистка набора данных — вероятно, самый важный шаг конвейера для достижения хорошего качества.
Мы применяем базовые техники очистки, которые работают для большинства наборов данных: удаление слишком коротких или слишком длинных предложений и фильтрацию пар с нереалистичным соотношением длины исходного и целевого текста. Мы также используем bicleaner — предварительно обучённый ML-классификатор, который пытается определить, является ли пример в наборе данных обратимым переводом. Затем мы можем удалить пары с низким баллом, которые, возможно, неверны или добавляют нежелательный шум.
Автоматизация необходима при большом объёме обучающего набора. Тем не менее рекомендуется вручную просматривать данные, чтобы настроить пороги очистки и добавить специфические исправления для набора данных, чтобы получить наилучшее качество.
В мире существует более 7000 языков, и большинство из них считаются языками с низкими ресурсами в нашем контексте, то есть для них доступно мало параллельных корпусов для обучения. В таких случаях мы используем популярную стратегию увеличения данных — обратный перевод (back-translation).
Обратный перевод — это техника увеличения объёма обучающих данных добавлением синтетических переводов. Мы получаем эти синтетические примеры, обучая модель перевода с целевого языка на исходный. Затем используем её для перевода монолингвальных данных целевого языка в исходный язык, создавая синтетические пары, которые добавляются в обучающий набор для модели, которую мы действительно хотим — от исходного языка к целевому.
Наконец, когда у нас есть очищенный параллельный корпус, мы обучаем большую трансформер-модель, чтобы достичь максимально возможного качества.
Когда модель сходится на расширенном наборе данных, мы дообучаем её на исходном параллельном корпусе без синтетических примеров из обратного перевода, чтобы дополнительно улучшить качество.
Обученная модель может быть размером 800 МБ и больше в зависимости от конфигурации и требовать значительных вычислительных ресурсов для выполнения перевода (декодирования). На этом этапе её обычно запускают на GPU, и она непрактична для большинства потребительских ноутбуков. На следующих шагах мы подготовим модель, эффективно работающую на потребительских CPU.
Основная техника сжатия, которую мы используем, — дистилляция знаний учитель–студент. Идея в том, чтобы сгенерировать большое количество переводов текста с исходного на целевой язык с помощью тяжёлой обученной модели (Учитель), а затем обучить гораздо меньшую модель с меньшим числом параметров (Студент) на этих синтетических переводах. Студент должен имитировать поведение учителя и показывать схожее качество перевода, оставаясь при этом значительно быстрее и компактнее.
Мы также дополняем параллельный корпус монолингвальными данными на исходном языке для декодирования. Это улучшает студента, давая дополнительные примеры поведения учителя.
Ещё один приём — использовать не одного учителя, а ансамбль из 2–4 учителей, независимо обученных на одном и том же параллельном корпусе. Это может немного повысить качество ценой необходимости обучения большего числа учителей. Конвейер поддерживает обучение и декодирование с ансамблем учителей.
Ещё одна популярная техника сжатия — квантизация. Мы используем 8-битную квантизацию, что по существу означает хранение весов нейросети как int8 вместо float32. Это экономит место и ускоряет матричное умножение на инференсе.
Другие полезные особенности, которые стоит упомянуть, но которые выходят за рамки этой уже длинной статьи: специализированная архитектура нейросети студента, декодирование половинной точности (half-precision) учителем для его ускорения, лексические шортлисты, обучение выравниваний слов и дообучение квантованного студента.
Да, этого много! Теперь вы понимаете, почему нам нужен был конвейер «от и до».
Эта работа основана на большом объёме исследований. Если вас интересует научная сторона конвейера обучения, ознакомьтесь с публикациями, перечисленными в README репозитория конвейера обучения и в рамках проекта Bergamot. Статья «Edinburgh’s Submissions to the 2020 Machine Translation Efficiency Task» — хорошая академическая отправная точка. Для более практического и операционного объяснения шагов смотрите туториал Николая Богоичева.
Финальная модель-студент в 47 раз меньше и в 37 раз быстрее оригинальной модели-учителя при лишь небольшом снижении качества!
Бенчмарки для модели en-pt и датасета Flores: (время декодирования на 1 CPU core)
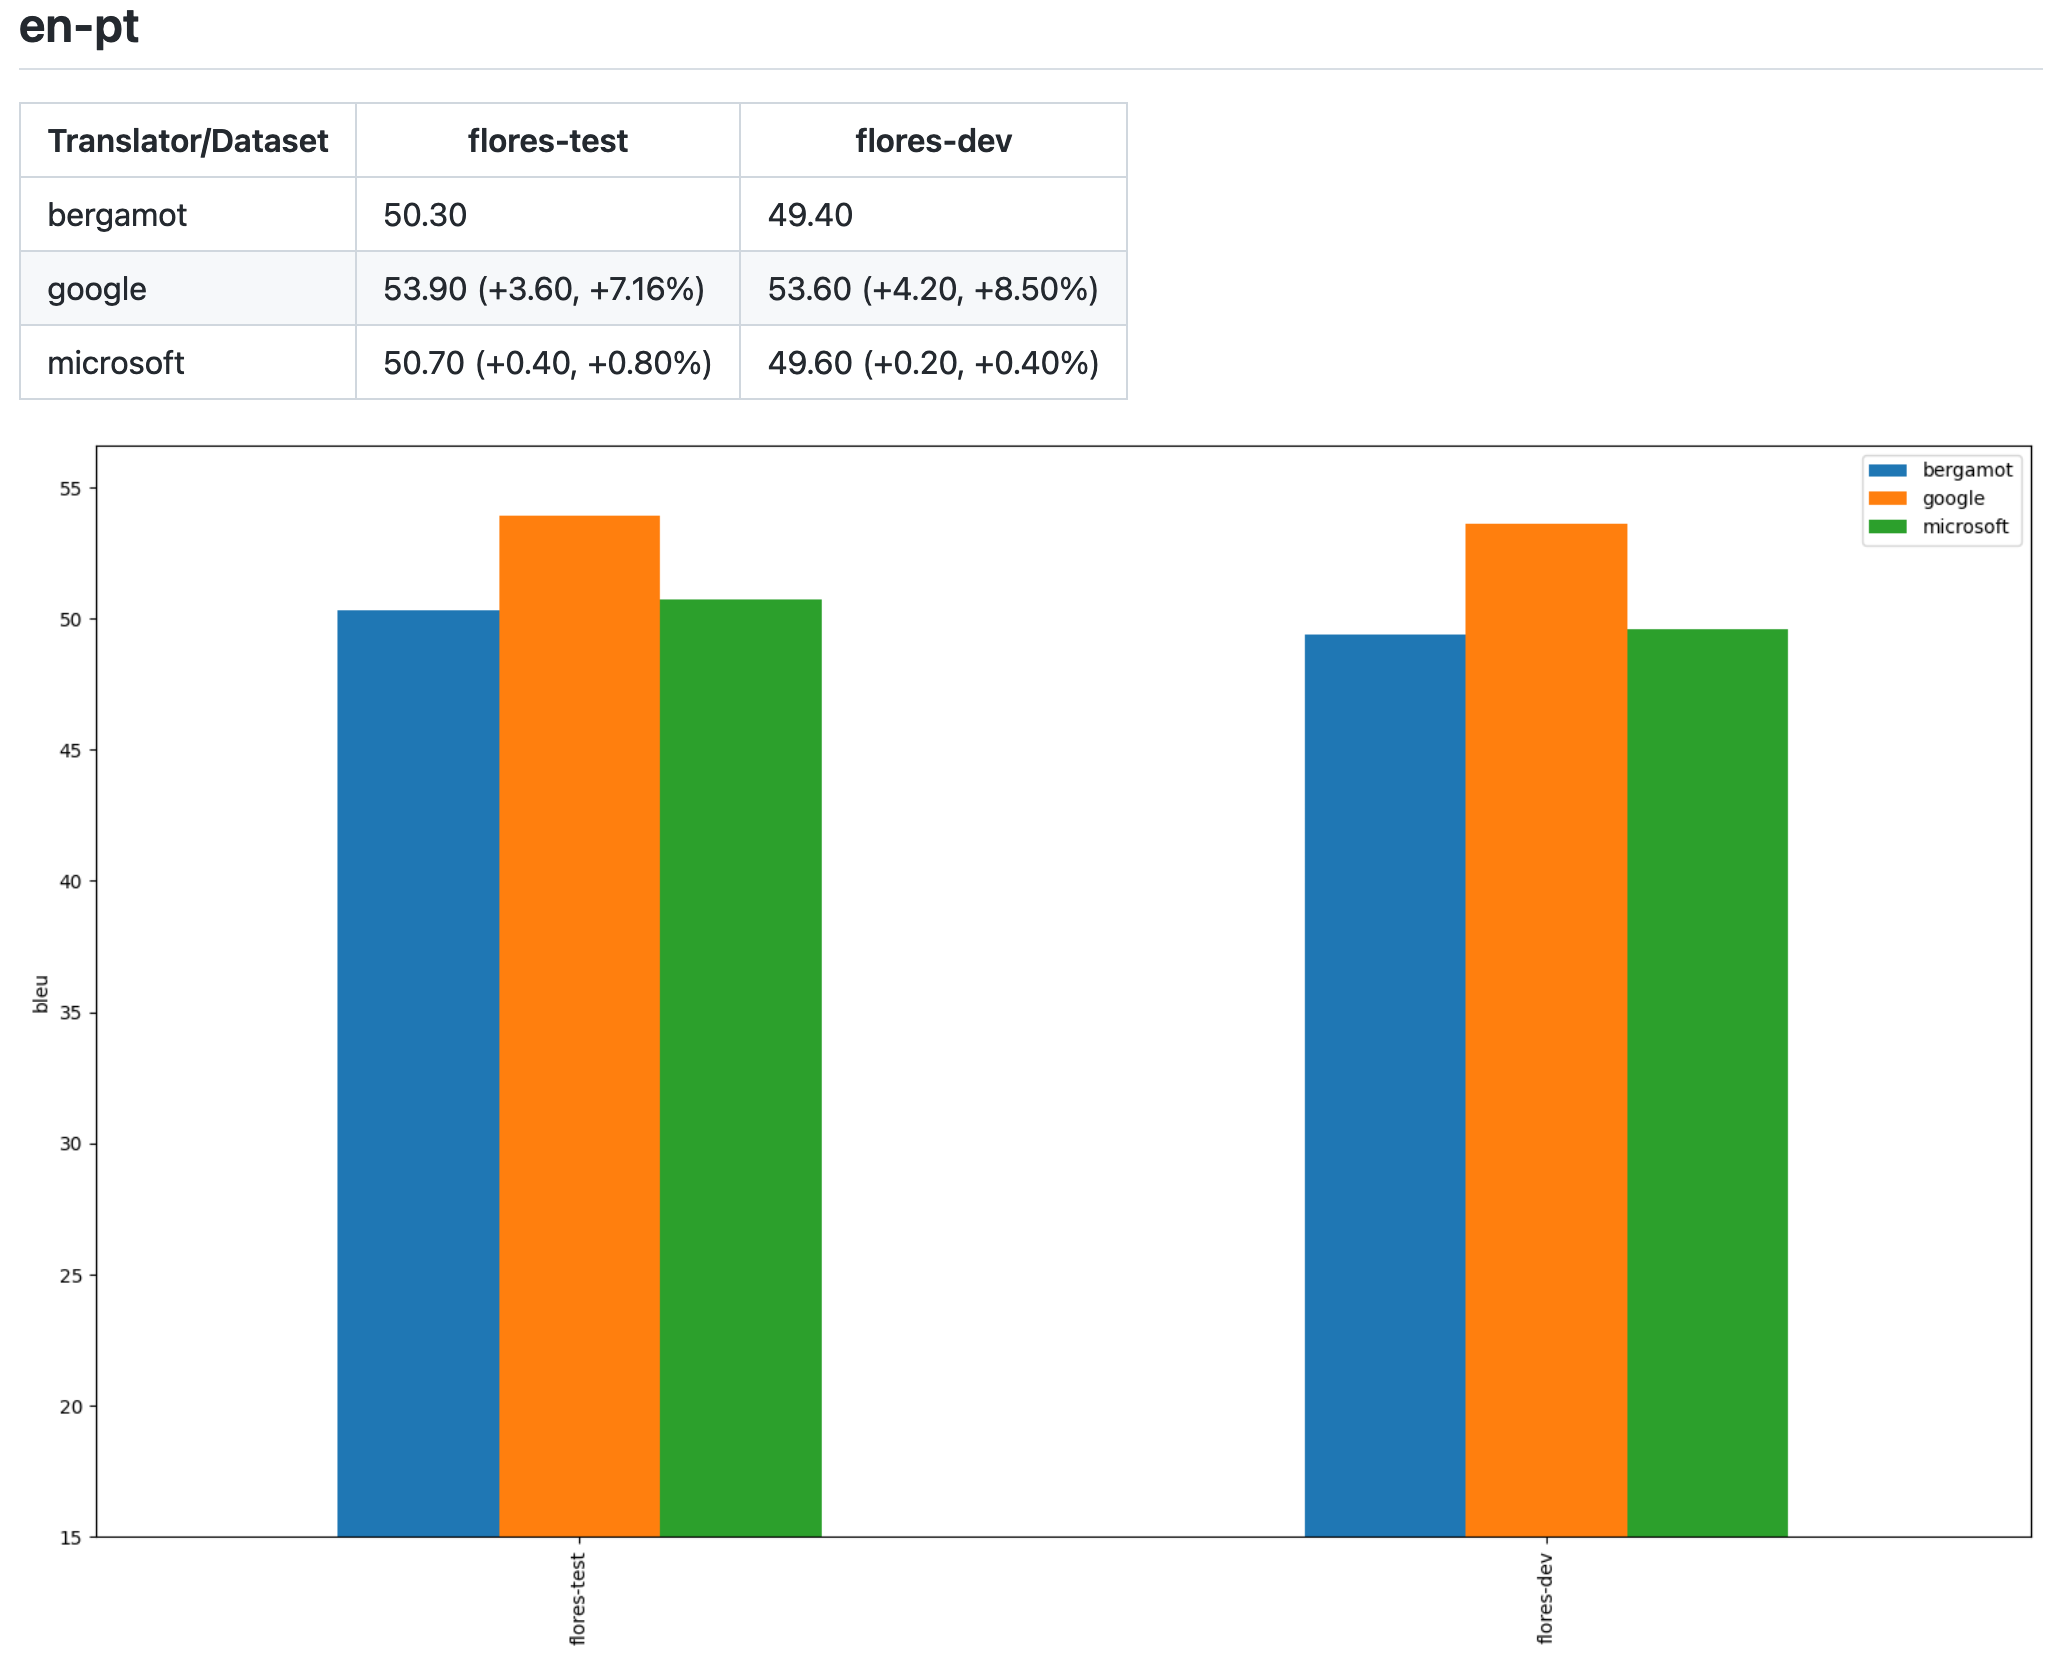
Мы оцениваем результаты с помощью стандартных для MT BLEU-метрик, которые по сути отражают, насколько переведённый и эталонный тексты похожи. Этот метод не идеален, но показано, что BLEU-корыелируют с человеческой оценкой качества перевода.
У нас есть репозиторий на GitHub со всеми обученными моделями и результатами оценки, где мы сравниваем точность наших моделей с популярными API облачных провайдеров. Мы видим, что некоторые модели работают сопоставимо или даже превосходят облачных провайдеров, что является отличным результатом с учётом эффективности, воспроизводимости и открытой природы наших моделей.
Например, в репозитории представлены результаты оценки модели с английского на португальский, обученной Mozilla только на открытых данных.
Любой желающий может обучать модели и вносить их в наш репозиторий. Эти вклады могут использоваться в веб-расширении Firefox Translations и в других местах.
Конечно, возможно запустить весь конвейер на одной машине, хотя это может занять значительное время. Некоторые шаги конвейера связаны с CPU и трудно параллелизуются, в то время как другие можно отдать нескольким GPU. Большинство официальных моделей в репозитории были обучены на машинах с 8 GPU. Некоторые шаги, такие как декодирование учителя при дистилляции знаний, могут занимать дни даже на мощной одной машине. Поэтому, чтобы ускорить процесс, мы добавили поддержку кластера, чтобы распределять различные шаги конвейера по нескольким узлам.
Для управления этой сложностью мы выбрали Snakemake, который очень популярен в биоинформатике. Он использует файловые рабочие процессы, позволяет задавать зависимости шагов на Python, поддерживает контейнеризацию и интеграцию с различным программным обеспечением кластеров. Мы рассматривали альтернативы, ориентированные на планирование заданий, но в конечном итоге выбрали Snakemake как более эргономичный для одноразовых экспериментальных рабочих процессов.
Для параллелизации шагов рабочего процесса по узлам кластера мы используем менеджер ресурсов Slurm. Он относительно прост в эксплуатации, хорошо подходит для высокопроизводительных экспериментальных рабочих процессов и поддерживает контейнеры Singularity для облегчения воспроизводимости. Slurm также является самым популярным менеджером кластеров для высокопроизводительных вычислений (HPC), используемых для обучения моделей в академической среде, и большинство партнеров консорциума уже использовали или хорошо знакомы с ним.
Рабочий процесс достаточно ресурсоёмкий, поэтому вам потребуется приличный сервер или даже кластер. Мы рекомендуем использовать 4–8 GPU уровня Nvidia 2080 или выше на машину.
Склонируйте репозиторий https://github.com/mozilla/firefox-translations-training и следуйте инструкциям в README для конфигурации.
Самая важная часть — найти параллельные наборы данных и правильно настроить параметры в соответствии с доступными данными и оборудованием. Подробнее об этом — в README.
Готовые модели поставляются с веб-расширением Firefox Translations, позволяя пользователям переводить веб-страницы в Firefox. Модели загружаются на локальную машину по требованию. Веб-расширение использует эти модели через оболочку bergamot-translator для Marian, скомпилированную в WebAssembly.
Также есть демонстрационный сайт https://mozilla.github.io/translate, где можно вводить текст и переводить его прямо сейчас локально, но как статический сайт, а не расширение браузера.
Если вас интересует эффективный NMT-инференс на сервере, вы можете попробовать прототип HTTP-сервиса, который использует bergamot-translator, собранный нативно, а не в WASM.
Или следуйте инструкциям по сборке в README bergamot-translator, чтобы использовать C++, JavaScript (WASM) или Python-обёртки напрямую.
Удивительно, насколько далеко продвинулись исследования в области машинного перевода за последние годы. Локальные высококачественные переводы — это будущее, и становится всё более практично для компаний и исследователей обучать такие модели даже без доступа к проприетарным данным или масштабным вычислительным мощностям.
Мы надеемся, что Firefox Translations задаст новый стандарт приватного, эффективного и открытого машинного перевода, доступного для всех.
Я хотел бы поблагодарить всех участников проекта Bergamot за то, что эта технология стала возможна; моих коллег Андре Натала и Абхишека Аггарвала за невероятную работу по реализованию Firefox Translations; Лоннена за управление проектом и редактирование этой публикации; и, конечно, замечательное сообщество Mozilla за помощь в локализации веб-расширения и тестировании ранних сборок.
Проект получил финансирование от программы исследований и инноваций Horizon 2020 Европейского Союза по соглашению о гранте № 825303.
Евгений — старший инженер-программист в Mozilla. Он работает над прикладными проектами в области машинного обучения.
Спасибо! Пожалуйста, проверьте почтовый ящик, чтобы подтвердить подписку.
Если вы ранее не подтверждали подписку на рассылку, связанную с Mozilla, вам возможно потребуется это сделать. Проверьте входящие или папку спама на предмет письма от нас.