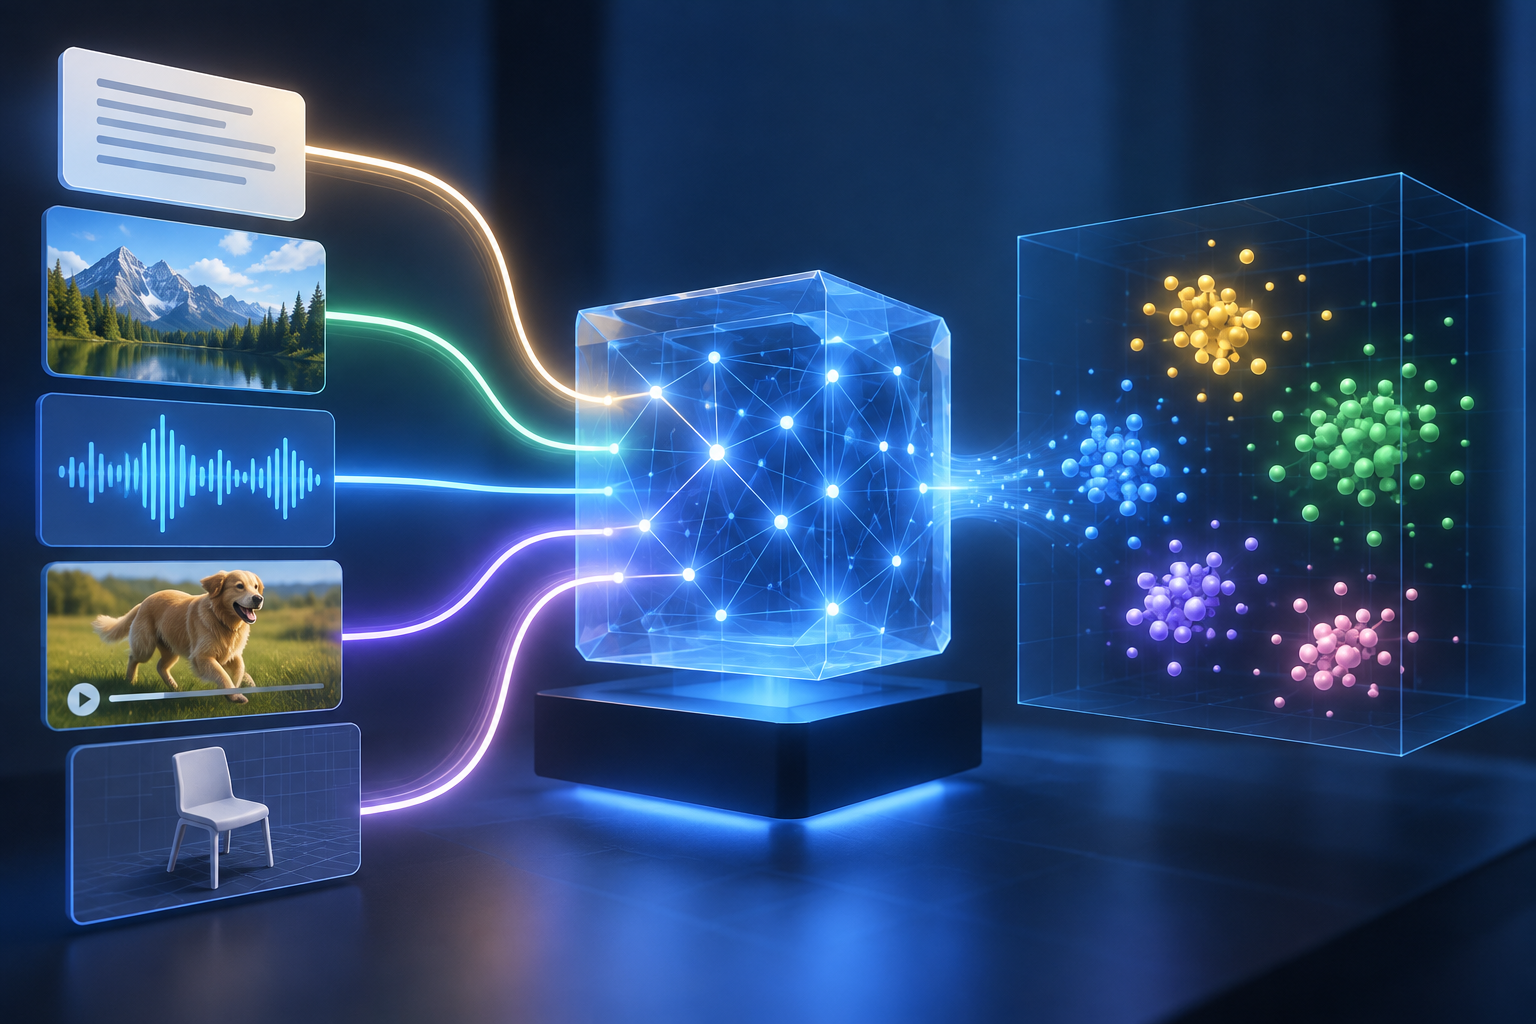
Google представила EmbeddingGemma 2 — мультимодальную модель, переводящую разные типы данных в общее векторное пространство. Это позволяет выполнять семантический поиск между текстом, изображениями, аудио и видео: например, сопоставлять текстовый запрос с фрагментом аудио или сценой из видео.
Полная модель содержит 740 миллионов параметров и имеет модульную архитектуру: для текстовых задач можно задействовать меньшую часть модели, а обработку изображений и аудио подключать отдельно. Выходные эмбеддинги поддерживают сокращение размерности с 768 до 512, 256 или 128 измерений, что даёт гибкость при оптимизации скорости и памяти.
Модель рассчитана на локальное извлечение эмбеддингов и может использоваться совместно с генеративной моделью в RAG-конвейере: эмбеддинги помогают найти релевантный материал, который затем подаётся генератору для формирования развёрнутого ответа.
Опубликованы веса модели и указана совместимость с несколькими инструментами разработки. Заявленные требования к памяти относятся к конкретной квантованной конфигурации и не являются универсальной гарантией потребления памяти в любых приложениях. При выборе длины эмбеддинга рекомендуется проверять качество поиска на собственных данных, поскольку сокращение размерности может влиять на релевантность результатов.